Când preiei un magazin online scris prin 2012–2014, impulsul clasic este să ștergi tot și să-l refaci de la zero în cel mai recent framework la modă. Pui FastAPI, microservicii și un frontend greoi în JavaScript care descarcă sute de megabiți de module.
Doar că în viața reală afacerile nu funcționează așa. Dacă magazinul vinde bine, paginile se deschid în sub 50 de milisecunde, indexarea în Google e impecabilă și clienții s-au obișnuit cu interfața, o rescriere completă e adesea o capcană. Pierzi poziții SEO acumulate în zece ani, introduci zeci de bug-uri în checkout și riști să blochezi afacerea luni întregi.
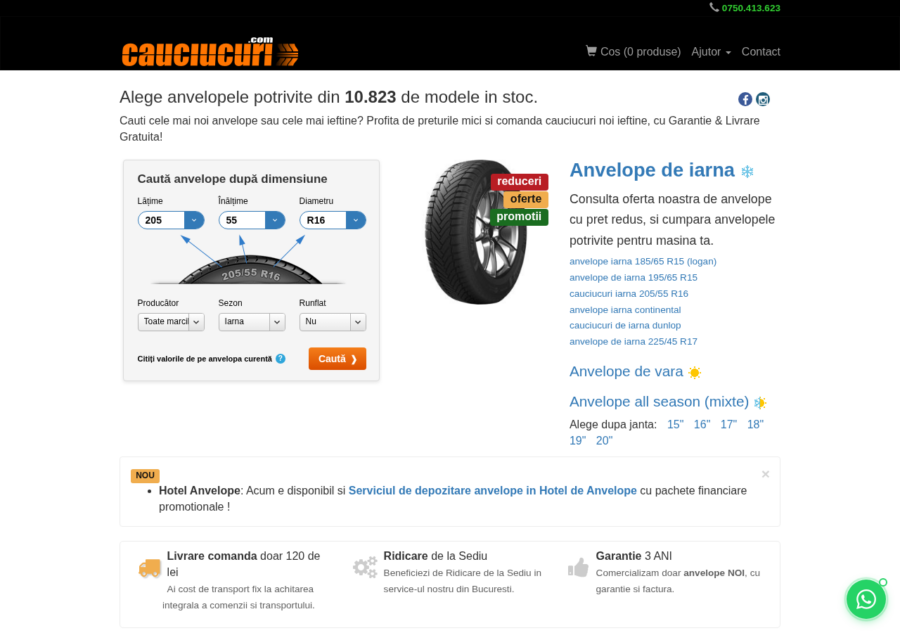
Exact aceasta a fost situația noastră: un magazin cu peste 11.000 de anvelope active, sincronizări zilnice automate și o viteză de reacție excelentă, construit pe Python 2.7, Tornado 4.2 și SQLAlchemy 1.1.
Problema? Pe un server nou cu Debian 13, Python 2 nu mai există în repo-urile oficiale, iar serverele externe cer protocoale de securitate (TLS 1.3) pe care vechiul stack nu le mai poate susține.
Am ales modernizarea chirurgicală a codului. Am păstrat structura bazei de date și template-urile HTML verificate în timp, dar am adus motorul interior pe Python 3.13, Tornado 6.5 și SQLAlchemy 2.0.
Cum arăta stack-ul tehnic din anii 2014–2018
Ca să înțelegem de unde am plecat, merită să ne uităm puțin în fișierul de dependențe găsit în backup-ul proiectului. Totul respira aerul generației trecute de dezvoltare web:
BeautifulSoup==3.2.1
lxml==2.3.6
mechanize==0.2.5
MySQL-python==1.2.5
SQLAlchemy==1.1.15
tornado==4.2
Whoosh==2.7.0
WTForms==2.0.2
wtforms-tornado==0.0.2
xlrd==0.9.3
Pe scurt, aveam:
- Un Tornado 4.2 bazat pe un event loop intern (IOLoop) scris înainte ca
asynciosă fie integrat nativ în biblioteca standard Python. - Un driver de bază de date (
MySQL-python) care compila direct cu legături C vechi, incompatibile cu bibliotecile moderne de sistem de pe un Linux proaspăt. - O versiune de SQLAlchemy (1.1) care încă funcționa pe stilul vechi de interogări cu paranteze drepte în clauzele select.
- O punte de legătură între WTForms și Tornado (
wtforms-tornado), abandonată complet pe GitHub de prin 2016. - O bibliotecă clasică pentru citirea fișierelor Excel (
xlrd), rămasă blocată în timp.
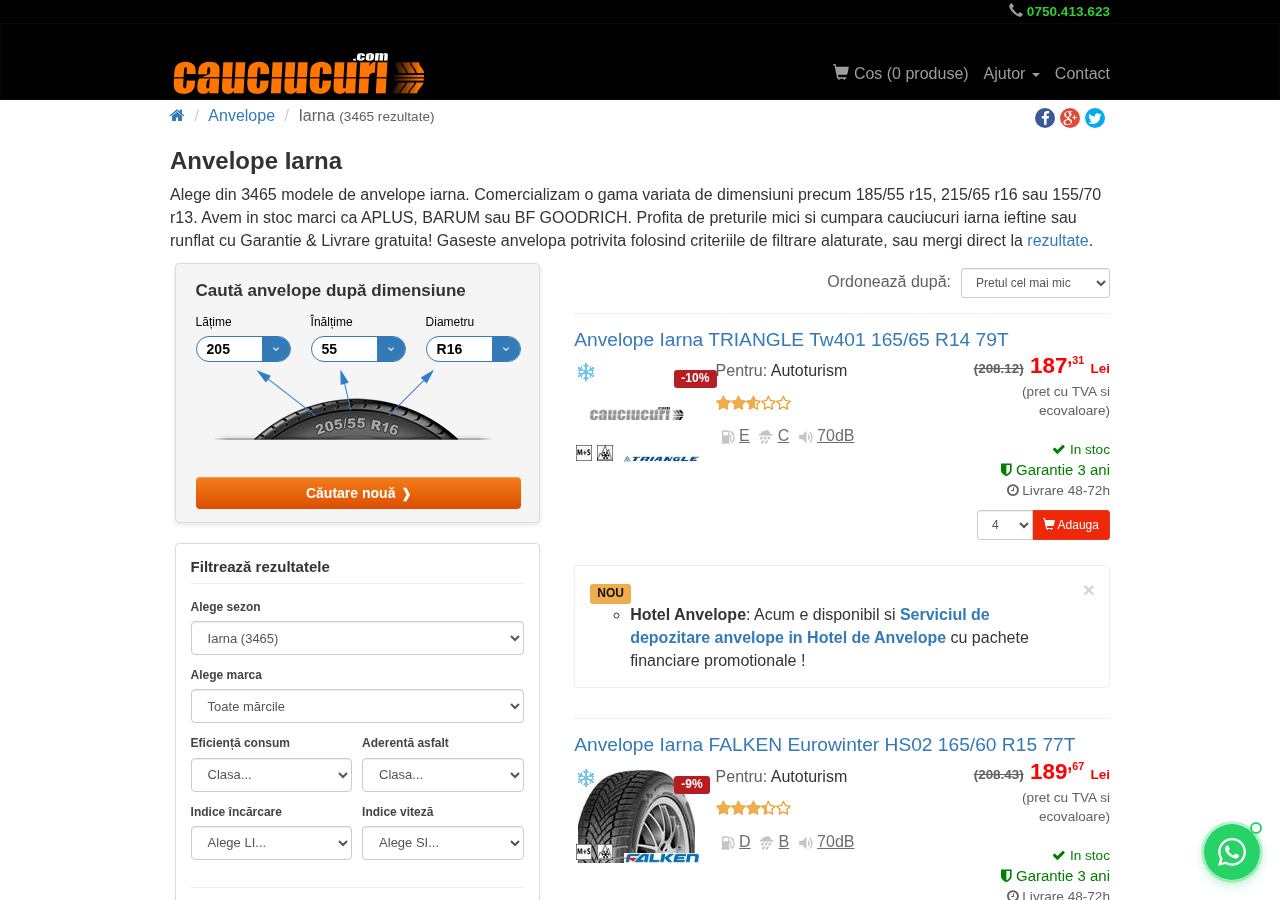
Ce a rămas neschimbat și valoros? Arhitectura de căutare. În loc să facem interogări greoaie de tip LIKE în tabele mari la fiecare căutare pe site, proiectul folosea biblioteca de căutare full-text Whoosh. Ea citește un view compact din baza de date și menține un index binar local pe disc, oferind filtrare fațetată (lățime, înălțime, diametru, sezon, clasă de eficiență) aproape instantaneu.
1. Bytes versus string: primul obstacol serios
Prima barieră peste care dai când treci orice aplicație de la Python 2 la Python 3 este distincția clară dintre șirurile de bytes și string-uri (str). În Python 2 puteai amesteca fără grijă cele două noțiuni, limbajul făcând conversii automate în spate. În Python 3, dacă încerci să combini sau să decodezi implicit, interpretorul se oprește imediat.
În Tornado 4, metoda get_secure_cookie() returna un string obișnuit. În Tornado 6, aceeași metodă returnează un obiect de tip bytes.
În codul vechi aveam pur și simplu:
# Versiunea veche (Python 2)
def get_cart(self):
    cookie_val = self.get_secure_cookie('cart')
    return json.loads(cookie_val or '{}')
Când am pornit aplicația în mediul nou cu Python 3.13, coșul de cumpărături arunca erori la fiecare adăugare de produs. Modulul json.loads() din versiunile recente de Python refuză să accepte anumiți bytes nevalidați. Dacă valoarea era goală, se returna None, iar operațiunea eșua direct cu o eroare de tip TypeError.
Rezolvarea a cerut o decodare explicită cu bloc de protecție:
# Versiunea modernizată (Python 3.13)
def get_cart(self):
    try:
        val = self.get_secure_cookie('cart')
        if isinstance(val, bytes):
            val = val.decode('utf-8')
        return json.loads(val or '{}')
    except Exception as e:
        logging.error("Eroare la parsarea JSON a cosului: %s", e)
        return {}
Aceeași situație am întâlnit-o la identificarea utilizatorilor conectați în panoul administrativ. Cookie-ul de sesiune trebuia convertit explicit din bytes în string înainte de a fi transmis ca parametru numeric într-o interogare SQL.
2. Salvarea formularelor: crearea unui adaptor MultiDict pentru WTForms
O mare bătaie de cap a fost gestionarea formularelor de comandă. În varianta inițială se folosea pachetul wtforms-tornado. Odată cu trecerea la WTForms 3, biblioteca veche a crăpat în totalitate din mai multe motive:
- Clasa
TextFielda fost ștearsă din WTForms în favoarea denumirii mai clareStringField. - Validarea
Requireda devenitDataRequired. - Dicționarul de argumente
self.request.argumentsdin Tornado stochează valorile ca liste de bytes: de exemplu, câmpul localitate sosea sub forma[b'Bucuresti'].
Când formularul încerca să citească datele trimise prin POST, utilizatorul vedea în câmpurile din pagină textul bizar b'Bucuresti', iar validatoarele de lungime sau caractere speciale eșuau zgomotos.
În loc să căutăm alte librării externe care riscă să fie abandonate peste câțiva ani, am preferat să scriem un adaptor curat de numai 20 de linii, direct în fișierul forms.py:
class TornadoMultiDict(object):
    def __init__(self, multidict):
        self.multidict = multidict

    def __iter__(self):
        return iter(self.multidict)

    def __len__(self):
        return len(self.multidict)

    def __contains__(self, key):
        return key in self.multidict

    def getlist(self, key):
        valori = self.multidict.get(key, [])
        return [x.decode('utf-8') if isinstance(x, bytes) else x for x in valori]

class Form(wtforms.Form):
    def __init__(self, formdata=None, obj=None, prefix='', **kwargs):
        if formdata is not None and not hasattr(formdata, 'getlist'):
            formdata = TornadoMultiDict(formdata)
        super(Form, self).__init__(formdata, obj, prefix, **kwargs)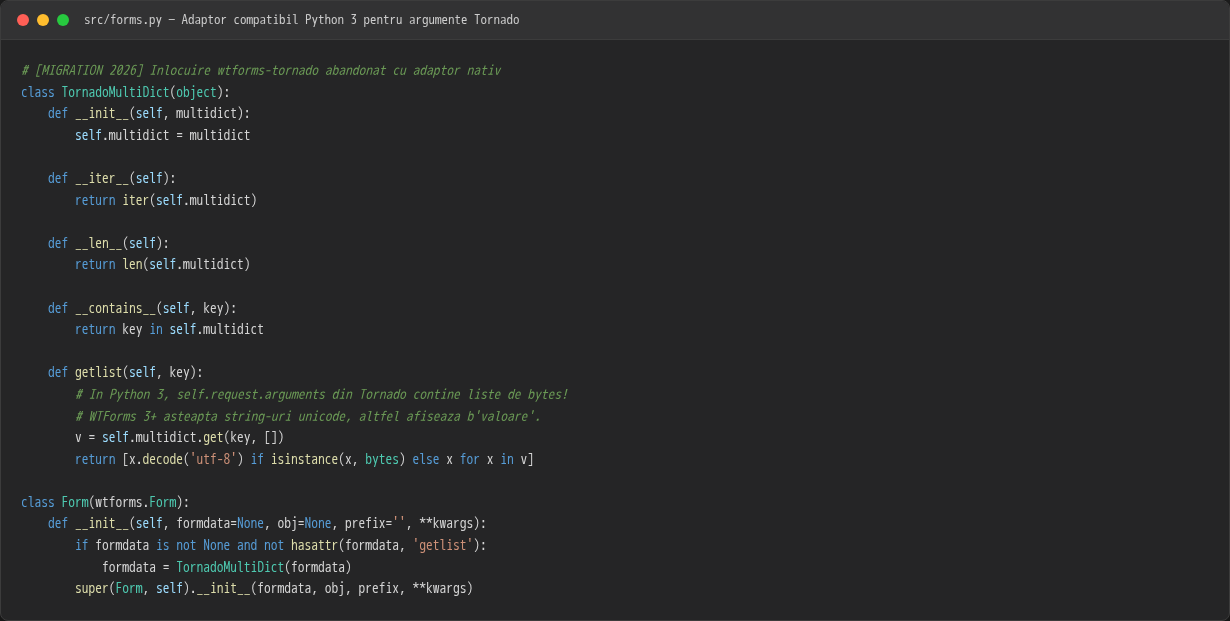
Cu această modificare simplă, toate formularele din magazin (date de facturare pentru persoane fizice, firme, selecție modalitate de plată și adrese de livrare) au început să funcționeze perfect, fără nicio dependență suplimentară.
3. SQLAlchemy 2.0 și capcana DeferredReflection
Un alt punct critic a fost stratul de date. Modelele din aplicație moștenesc clasa DeferredReflection. Acest mecanism este excelent când vrei ca SQLAlchemy să inspecteze automat structura tabelelor la pornire, fără să fie nevoie să redeclari fiecare coloană de mână în fișierele Python:
Base = declarative_base(cls=DeferredReflection)În SQLAlchemy 1.1, lucrurile mergeau liniar. Puteai să ai clase ORM goale și să definești proprietăți hibride care făceau trimitere la coloane ce urmau să fie mapate ulterior la apelul Base.prepare(engine).
În SQLAlchemy 2.0, regulile jocului s-au schimbat drastic. Motorul este mult mai strict în privința verificării tipurilor și atributelor la faza de import a modulelor.
Dacă o clasă conținea o expresie hibridă de forma:
@pricing_rule_value.expression
def pricing_rule_value(cls):
    return select(PricingRule.value).where(
        PricingRule.furnizor_id == cls.furnizor_id
    )
Interpretorul arunca o excepție fatală chiar la pornirea serverului:
AttributeError: type object 'PricingRule' has no attribute 'furnizor_id'Motivul? Expresia hibridă este evaluată de Python la definirea clasei, moment în care DeferredReflection încă nu rulase interogarea de inspecție a bazei de date. Clasa pur și simplu nu știa că tabela din spate conține coloana respectivă.
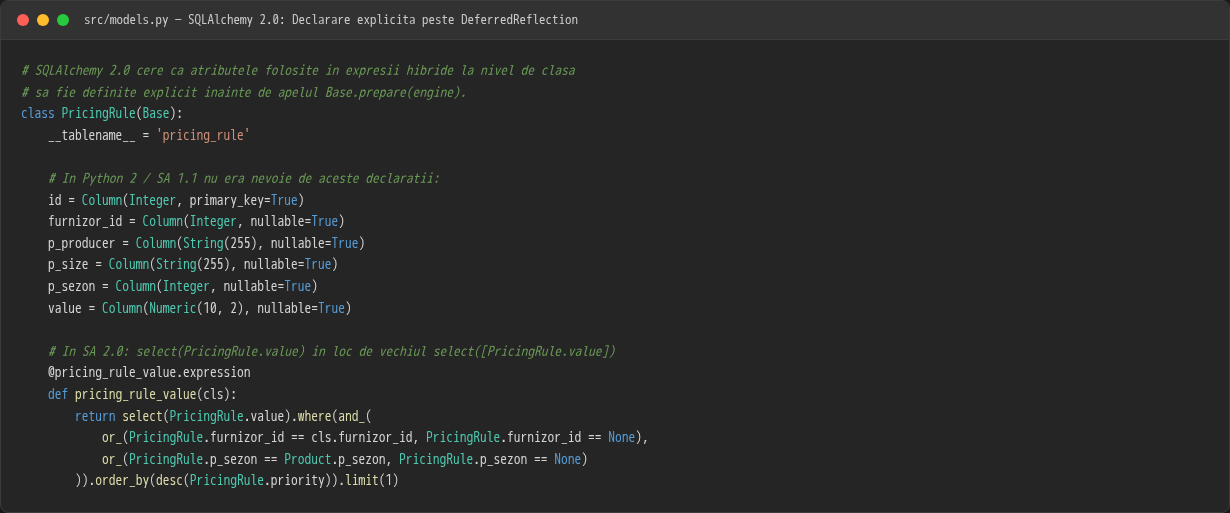
Soluția a fost să declarăm explicit în model doar acele câteva coloane care participă direct la construirea clauzelor SQL hibride:
class PricingRule(Base):
    __tablename__ = 'pricing_rule'

    # Declarate explicit pentru a fi recunoscute inainte de Base.prepare()
    id = Column(Integer, primary_key=True)
    furnizor_id = Column(Integer, nullable=True)
    p_producer = Column(String(255), nullable=True)
    p_size = Column(String(255), nullable=True)
    p_sezon = Column(Integer, nullable=True)
    value = Column(Numeric(10, 2), nullable=True)

    @pricing_rule_value.expression
    def pricing_rule_value(cls):
        return select(PricingRule.value).where(and_(
            or_(PricingRule.furnizor_id == cls.furnizor_id, PricingRule.furnizor_id == None),
            or_(PricingRule.p_sezon == Product.p_sezon, PricingRule.p_sezon == None)
        )).order_by(desc(PricingRule.priority)).limit(1)
Tot aici am curățat apelurile vechi select([coloana]) care fuseseră complet eliminate în noul ORM, înlocuindu-le cu apelul standard select(coloana).
4. Ce faci când biblioteca de Excel refuză să mai citească fișiere noi?
În fiecare dimineață, devreme, un script de sincronizare descarcă actualizările de stoc de la depozitele partenere. Unul dintre cataloage sosește sub formă de tabel Excel cu zeci de mii de rânduri în format xlsx.
În stack-ul original se folosea biblioteca xlrd. Totul mergea ceas până când, începând cu versiunea 2.0, autorii xlrd au decis să elimine definitiv suportul pentru xlsx, păstrând doar suportul pentru formatul arhaic xls, din motive de securitate.
Dacă încercai să deschizi catalogul în noul virtualenv, primeai sec:
XLRDError: Excel xlsx file; not supportedScriptul de import conținea sute de linii de parsare matematică bazate pe API-ul specific xlrd: accesa sheet.nrows și apela sheet.cell(row, col).value. Rescrierea întregului flux pe biblioteca modernă openpyxl ar fi însemnat ore bune de refactorizare și riscul de a greși indicii coloanelor.
Am recurs la un model clasic de programare: duck typing printr-un adaptor transparent. Am scris o clasă minusculă peste openpyxl care respectă aceeași interfață pe care o aștepta vechiul script:
class OpenpyxlWork:
    def __init__(self, sheet):
        self.sheet = sheet

    def nrows(self):
        return self.sheet.max_row

    def cell(self, row, col):
        # openpyxl incepe numaratoarea de la 1, in timp ce xlrd o incepea de la 0
        return self.sheet.cell(row=row + 1, column=col + 1).value
În loc să modificăm zeci de funcții complexe, am schimbat doar inițializarea fișierului: am încărcat workbook-ul cu openpyxl și l-am împachetat în clasa OpenpyxlWork. Scriptul a continuat să ruleze fără să observe vreo diferență.
5. Mici detalii de sintaxă care pot opri producția
Pe lângă bibliotecile mari, migrarea de la Python 2 la 3 aduce o colecție de mici obstacole sintactice care scapă la o privire superficială.
Tuple unpacking în funcții lambda / anonime
În Python 2 era permis să scrii:
# Permis in Python 2, eroare de sintaxa in Python 3
producatori = filter(lambda (k, v): k == 'marca', filtre_aplicate)
În Python 3, unpacking-ul parametrilor în lambda a fost eliminat din limbaj, generând o eroare SyntaxError. Codul a fost rescris folosind indexare directă:
producatori = list(filter(lambda x: x[0] == 'marca', filtre_aplicate))Generatorii din template-urile Tornado
În Python 2, funcțiile filter() și zip() returnau direct liste. În Python 3, ele returnează generatoare ce pot fi parcurse o singură dată. Când template-ul HTML încerca să verifice lungimea listei de filtre sau să o parcurgă de două ori, randarea paginii crăpa:
TypeError: object of type 'filter' has no len()Soluția a fost convertirea lor explicită în liste ori de câte ori sunt transmise către motorul de template-uri.
Arhitectura de producție pe Debian 13
După ce tot codul a fost testat și adus la zi, l-am instalat pe un server curat, configurat robust pentru trafic susținut.
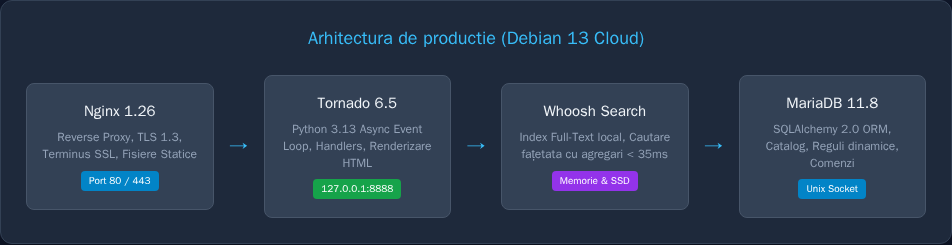
- Nginx 1.26: Preia conexiunile securizate pe portul 443, gestionează certificatele Let’s Encrypt prin TLS 1.3 și servește direct fișierele statice (imagini de produs, stiluri CSS, scripturi frontend).
- Tornado 6.5: Rulează ca serviciu systemd independent pe portul local 8888. Datorită naturii asincrone, un singur proces Python gestionează sute de conexiuni concurente fără să consume cantități mari de memorie RAM.
- Whoosh Search Index: Menține un index binar compact pe stocarea rapidă SSD. Orice căutare după dimensiuni (de exemplu: 205/55 R16) este rezolvată în mai puțin de 35 de milisecunde.
- MariaDB 11.8: Păstrează comenzile clienților, istoricul prețurilor și regulile comerciale, conectându-se local prin socket Unix cu latență zero.
Ce am învățat din această experiență
Nu rescrie dacă poți moderniza. Aplicațiile mature au în spate ani de ajustări fine, excepții tratate pentru date primite haotic și optimizări specifice domeniului. O rescriere completă aruncă la coș toată această experiență acumulată.
Păstrează frontend-ul intact dacă își face treaba. Utilizatorii magazinului sunt interesați să găsească repede anvelopa dorită, să compare clasa de consum și să plaseze comanda în trei pași. Faptul că interfața folosește HTML curat, Bootstrap și jQuery bine organizat înseamnă că paginile se deschid instant pe orice telefon, fără framework-uri greoaie care să blocheze procesorul.
Construiește adaptoare, nu rescrie logica de business. Când o bibliotecă externă își schimbă interfața sau dispare, un adaptor mic de tip duck typing îți permite să salvezi sute de linii de cod funcțional.
Magazinul rulează astăzi stabil pe cel mai nou sistem de operare, consumă sub 300 MB de memorie RAM și este pregătit pentru încă un deceniu de funcționare fără întreruperi.